

 Sécurité 100 % vérifiée | Aucun abonnement requis | Aucun logiciel malveillant
Si votre activité nécessite des transcriptions rapides et précises, intégrer des API de reconnaissance vocale à votre flux de travail peut être particulièrement utile. Heureusement, nombre de ces services proposent une formule gratuite pour simplifier la transcription sans alourdir votre budget.
Pour vous aider à choisir, nous avons sélectionné les meilleures API gratuites de transcription audio en texte disponibles, avec leurs principales fonctionnalités, leurs limites et les étapes pour les intégrer à vos projets. Si ces solutions ne répondent pas à vos attentes, nous vous présentons également une alternative plus adaptée à certains usages.
Dans cet article
Partie 1. Les meilleures API gratuites de transcription audio en texte
Avec la demande croissante de transcription audio dans la création de contenu, l'enseignement et les entreprises, une question revient souvent : « Quelles API ou solutions en ligne gratuites permettent de convertir la parole en texte ? »
Les API de reconnaissance vocale permettent aux développeurs d'intégrer la transcription dans leurs applications. Voici une présentation détaillée de cinq services proposant des possibilités d'utilisation gratuite : Google Cloud Speech-to-Text, Microsoft Azure Speech Service, Speechmatics, AssemblyAI et AWS Transcribe.
1. Google Cloud Speech-to-Text API
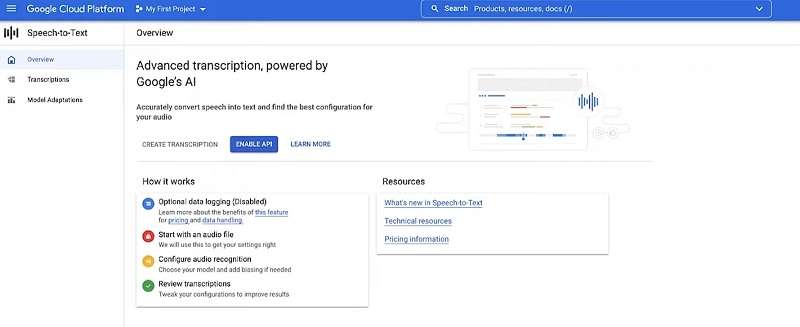
L'API Google Cloud Speech-to-Text fait partie des services Google Cloud et convertit les enregistrements audio en texte. Ses interfaces permettent aux développeurs d'ajouter la reconnaissance vocale à leurs applications. Selon l'offre décrite ici, Google propose 60 minutes de transcription gratuites. Les nouveaux utilisateurs peuvent aussi découvrir Speech-to-Text et d'autres services Google Cloud avec jusqu'à 300 $ de crédits offerts.
Fonctionnalités principales :
- Utilise Chirp, le modèle de reconnaissance vocale avancé de Google Cloud, entraîné sur des millions d'heures d'audio et des milliards de phrases
- Prend en charge 125 langues et variantes pour répondre à des besoins linguistiques variés
- Propose plusieurs modèles entraînés pour des usages spécifiques, notamment la commande vocale, la transcription d'appels téléphoniques et de vidéos
- Utilise des techniques d'adaptation des modèles pour mieux reconnaître les termes fréquents, enrichir le vocabulaire et améliorer les résultats en présence de bruit
Limites :
- La formule gratuite est limitée à 60 minutes de transcription par mois, ce qui peut être insuffisant pour des projets volumineux ou des besoins réguliers
- Le service peut être moins pratique pour les personnes qui ne connaissent pas Google Cloud. Il faut envoyer les fichiers audio dans un bucket Google Cloud Storage avant la transcription
- Certaines options de personnalisation avancées peuvent ne pas être entièrement accessibles dans la version gratuite
Idéal pour : les besoins ponctuels de transcription, notamment les petites entreprises ou indépendants qui transcrivent de courts entretiens, podcasts ou réunions.
2. Microsoft Azure Speech API
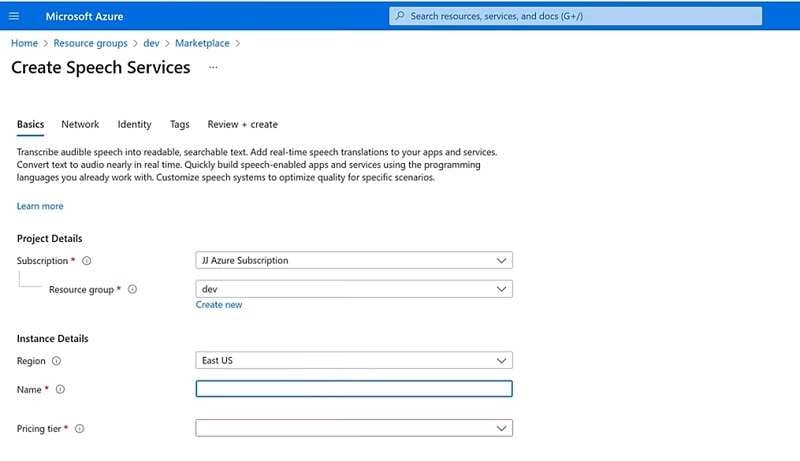
L'API Microsoft Azure Speech fait partie des services cognitifs Azure. Elle dispose d'une formule gratuite avec un volume d'utilisation limité, adaptée aux petits projets, aux tests et à l'apprentissage. Le service propose notamment la transcription en temps réel et des modèles vocaux personnalisables. Consultez la page des tarifs de Microsoft Azure pour en savoir plus.
Fonctionnalités principales
- Récupérer, sur demande, les journaux propres à chaque point de terminaison
- Accéder au manifeste des modèles créés pour configurer des conteneurs sur site
- Importer des données depuis des comptes de stockage Azure au moyen d'une URI de signature d'accès partagé (SAS)
- Utiliser vos propres comptes de stockage pour gérer les journaux, les transcriptions et d'autres données
- Transcrire par lots des fichiers audio provenant de plusieurs URL ou d'un conteneur Azure
Limites
- La formule gratuite permet d'héberger un seul modèle vocal personnalisé par mois et inclut uniquement 5 heures d'audio gratuites par mois
- Bien que la transcription Azure soit généralement précise, certains mots peuvent occasionnellement être mal orthographiés
- La configuration initiale de l'API Azure Speech peut être complexe
Idéal pour : les secteurs de la santé, de la finance et du droit, dans lesquels une terminologie spécialisée revient fréquemment.
3. Speechmatics
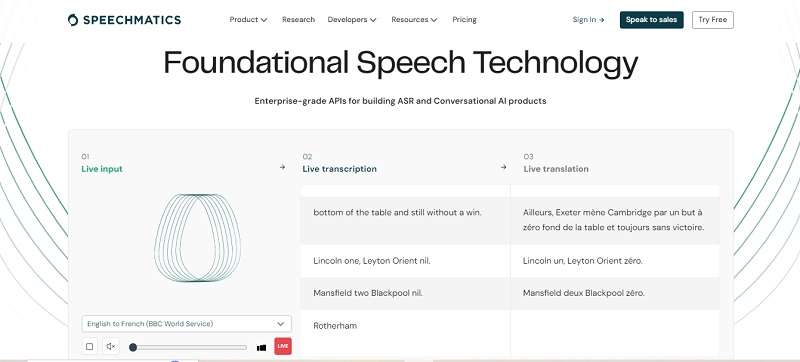
Speechmatics propose une API de transcription vocale avec une formule gratuite annoncée à 8 heures par mois : 4 heures de traitement par lots et 4 heures supplémentaires de transcription en temps réel. Conçu pour différents usages, de la production audiovisuelle au service client, le service s'appuie sur des algorithmes d'apprentissage automatique visant à produire des transcriptions fiables, y compris dans des conditions audio difficiles.
Fonctionnalités principales
- Prend en charge environ 50 langues et couvre de nombreux accents et dialectes
- Propose une transcription en temps réel avec une latence inférieure à une seconde
- Identifie automatiquement la langue parlée
- Associe à chaque mot transcrit un horodatage précis
- Permet d'exporter les transcriptions sous forme de sous-titres SRT
Limites
- La mise en place nécessite de configurer des interfaces personnalisées et convient davantage aux entreprises disposant de ressources techniques
- Les exigences techniques peuvent la rendre peu adaptée aux petites entreprises ou aux projets modestes
Idéal pour : les entreprises ayant d'importants volumes de transcription.
4. AssemblyAI
AssemblyAI propose des modèles de reconnaissance vocale fondés sur l'IA, accessibles par API. Selon l'offre présentée, les nouveaux utilisateurs reçoivent 50 $ de crédits gratuits pour commencer. Le service couvre notamment l'identification des locuteurs, la détection des sujets, l'analyse des sentiments et le résumé de textes. Deux options de transcription sont proposées : « Best » pour privilégier la précision et « Nano » pour réduire les coûts.
Fonctionnalités principales
- Identification et distinction des différents intervenants dans un enregistrement audio
- Personnalisation de l'orthographe et du vocabulaire pour mieux transcrire des mots particuliers ou des termes spécialisés
- Masquage automatique des propos inappropriés et ajout de la ponctuation et des majuscules pour faciliter la lecture
Limites
- Prend en charge moins de langues que certains concurrents
- Certains bogues ou problèmes peuvent demander du temps avant d'être résolus
- La transcription peut manquer de précision lorsque l'enregistrement contient beaucoup de bruit de fond ou de perturbations
Idéal pour : la transcription de réunions, d'entretiens ou de podcasts avec plusieurs intervenants.
5. AWS Transcribe
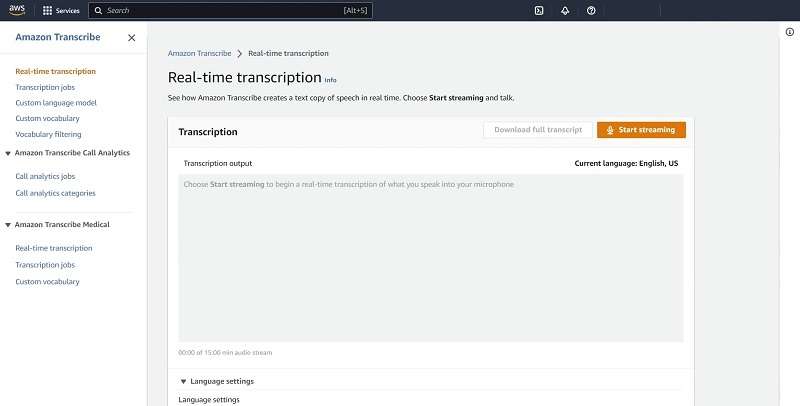
Amazon Transcribe, un service AWS, permet selon l'offre décrite aux nouveaux utilisateurs de transcrire gratuitement une heure d'audio par mois durant leur première année. Il convertit les enregistrements vocaux en texte pour différents usages, mais nécessite le stockage des fichiers audio dans Amazon S3.
Fonctionnalités principales
- Options de ponctuation et de mise en forme
- Vocabulaire personnalisé pour les termes propres à un secteur
- Identification de plusieurs intervenants
- Transcription de flux audio en direct ou de paroles préenregistrées
Limites
- Nécessite de stocker les fichiers audio dans Amazon S3
- Peut manquer certains mots spécifiques, notamment les noms propres ou les entités nommées (NER)
Idéal pour : les entreprises qui souhaitent automatiser la transcription de réunions, de contenus multimédias ou d'échanges avec le service client.
Partie 2. Comment intégrer une API de transcription vocale
Pour intégrer une API de transcription vocale, chaque fournisseur met généralement à disposition une documentation et des ressources techniques. Vous devez d'abord créer un compte auprès du service, puis générer des identifiants d'API qui vous permettront d'y accéder.
Prenons l'exemple de Google Cloud Speech-to-Text, une API de reconnaissance vocale largement utilisée. Sa documentation est disponible ici. L'intégration comprend plusieurs étapes :
- Créer un projet Google Cloud : Inscrivez-vous sur Google Cloud, puis créez un projet dans Google Cloud Console. Ce projet regroupera les ressources associées à votre API.
- Activer l'API Speech-to-Text : Accédez à la section API et services, recherchez Speech-to-Text, puis activez l'API pour votre projet.
- Générer les identifiants d'API : Créez un compte de service et générez les identifiants nécessaires pour authentifier vos requêtes. Téléchargez le fichier de clé, généralement au format JSON, et conservez-le en lieu sûr.
- Configurer la bibliothèque cliente : Installez la bibliothèque cliente appropriée, par exemple pour Python, Java ou Node.js, afin d'interagir avec l'API depuis votre code. Elle simplifie l'envoi des requêtes et le traitement des réponses.
- Écrire le code de transcription audio : Utilisez les identifiants et la bibliothèque cliente pour envoyer les données audio aux serveurs Google Cloud et récupérer leur transcription sous forme de texte.
Consultez le tutoriel complet expliquant comment intégrer l'API gratuite Google Cloud Speech-to-Text à votre application.
Partie 3. Transcrire la parole sans intégrer d'API
Tous les utilisateurs et toutes les entreprises n'ont pas besoin d'intégrer une API : la configuration peut être complexe, chronophage et inutile pour un projet individuel ou de petite taille. Il existe une autre façon de convertir la parole en texte sans développement spécifique : la fonction Speech-to-Text de Wondershare Filmora.
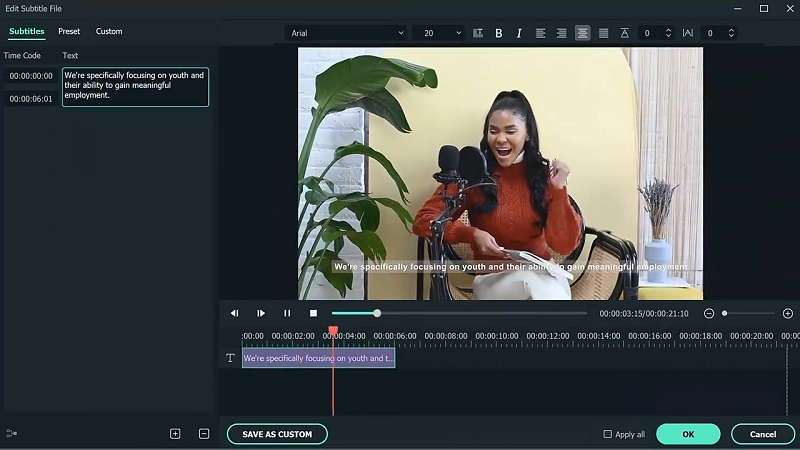
La fonction de transcription vocale de Filmora
Filmora est un logiciel de montage vidéo doté d'une fonction intégrée de conversion de la parole en texte. Vous pouvez transcrire directement les voix présentes dans un fichier audio ou vidéo et générer rapidement des sous-titres ou une transcription. Aucune retranscription manuelle ni configuration technique complexe n'est nécessaire : le processus est automatisé.
Pour les projets multilingues, la transcription vocale de Filmora prend également en charge plusieurs langues, dont l'anglais, le français, l'espagnol, l'indonésien, l'hindi et le japonais.
Quand choisir la transcription vocale de Filmora plutôt qu'une API ?
- Utilisateurs sans compétences techniques : Si vous n'avez pas de connaissances en développement ni d'équipe technique, l'interface de Filmora vous permet d'éviter l'intégration d'une API.
- Projets à réaliser rapidement : Pour transcrire rapidement une vidéo courte, créer des sous-titres ou préparer un contenu, le traitement automatisé de Filmora évite la configuration manuelle d'un service API.
- Montage de contenus vidéo : Filmora réunit le montage vidéo et la transcription vocale : vous pouvez donc intégrer directement le texte transcrit à vos projets, sous forme de sous-titres ou de transcription, sans changer d'outil.
Tutoriel : utiliser la transcription vocale dans Filmora
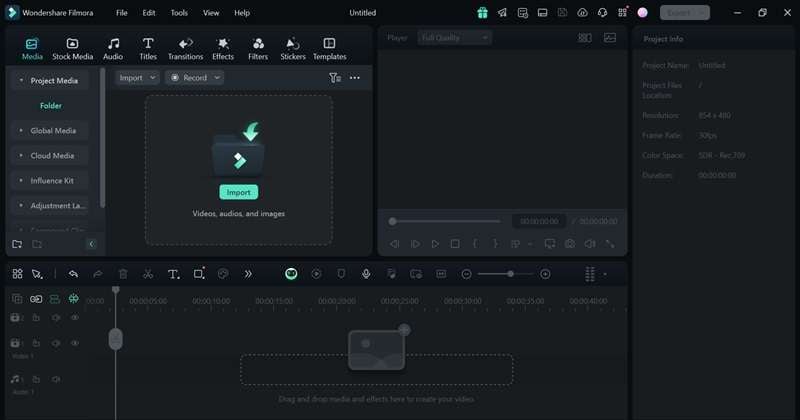
Étape 1 : Ouvrir Filmora et importer un fichier audio
Assurez-vous que la dernière version de Filmora est installée sur votre ordinateur. Lancez le logiciel, puis cliquez sur Nouveau projet pour créer un projet.
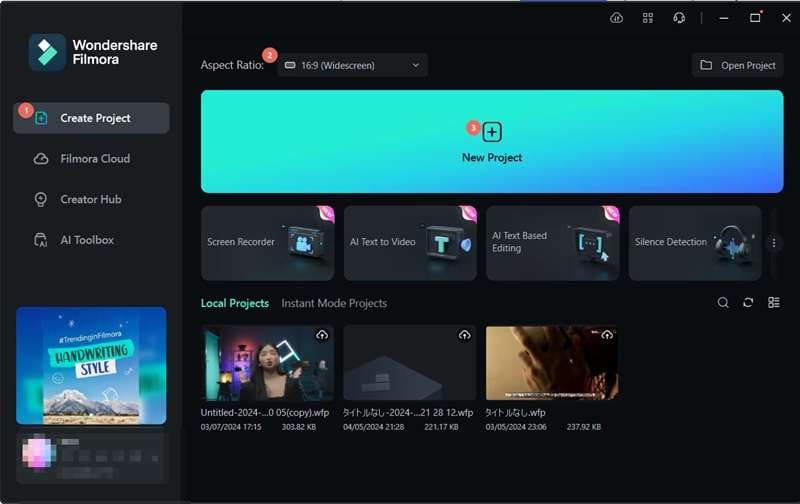
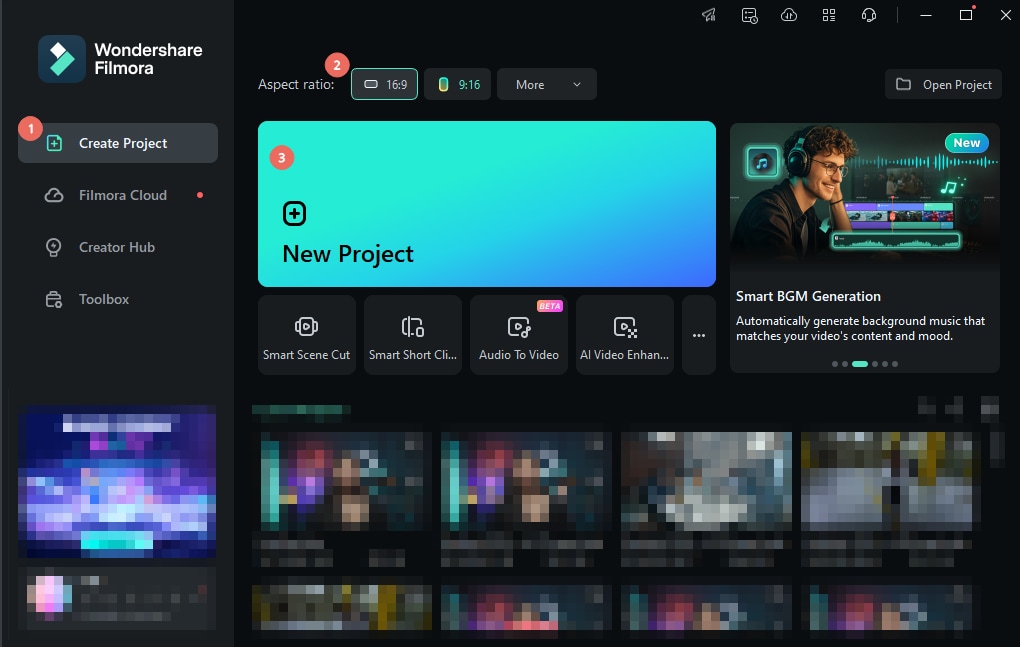
Pour ajouter votre fichier audio, cliquez sur Importer et sélectionnez le fichier sur votre ordinateur.
Étape 2 : Accéder à l'outil de transcription vocale
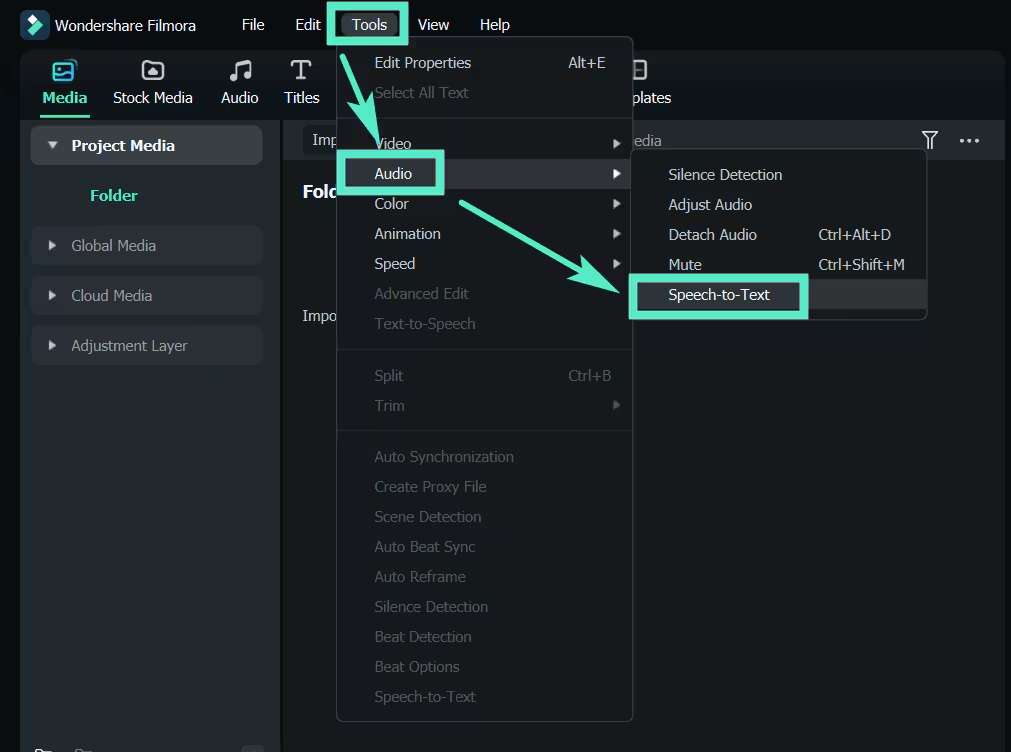
Une fois votre fichier audio importé, faites-le glisser sur la timeline. Sélectionnez ensuite la piste audio et ouvrez le menu Outils > Audio > Transcription vocale.
Étape 3 : Configurer les préférences de transcription
Une fenêtre de configuration de la fonction de transcription vocale s'ouvre. Vous pouvez y sélectionner la langue de l'enregistrement. Si vous n'avez pas besoin de traduction, choisissez l'option « Aucune traduction » dans la rubrique « Langue de traduction ».
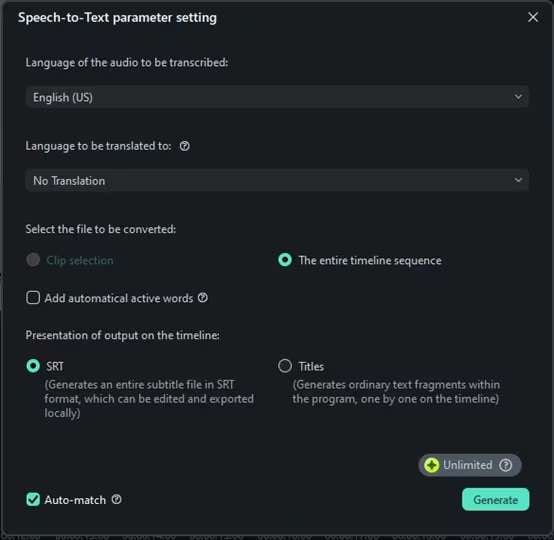
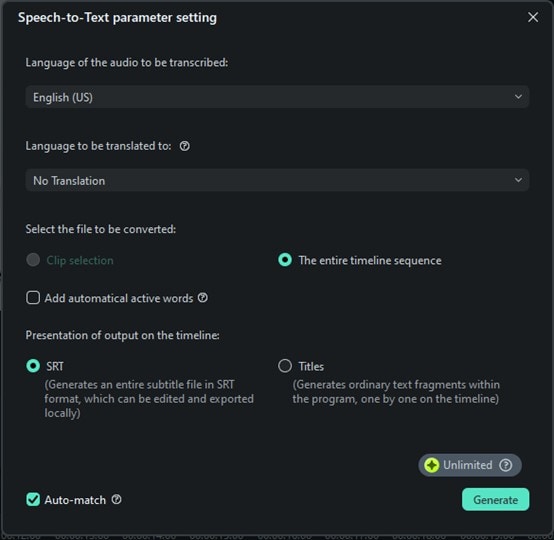
Vous pouvez également choisir de transcrire uniquement le clip audio sélectionné ou l'ensemble de la timeline. Sélectionnez ensuite le format de sortie SRT.
Étape 4 : Lancer la transcription audio
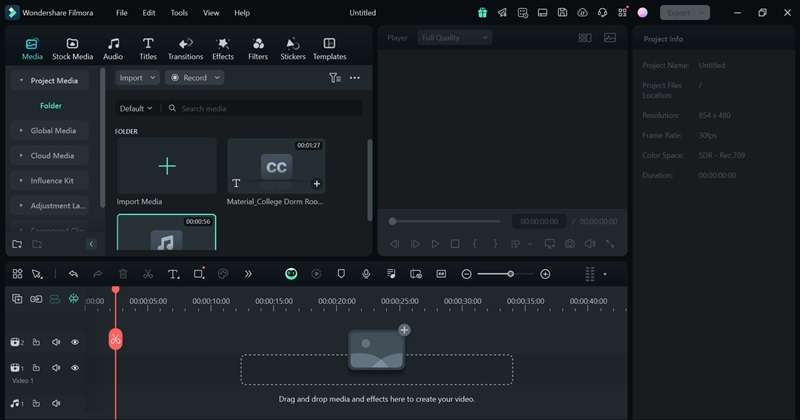
Une fois les réglages effectués, cliquez sur Générer . Filmora traite l'audio et crée la transcription. Une fois le traitement terminé, le fichier obtenu apparaît dans l'onglet Médias .
Étape 5 : Corriger la transcription
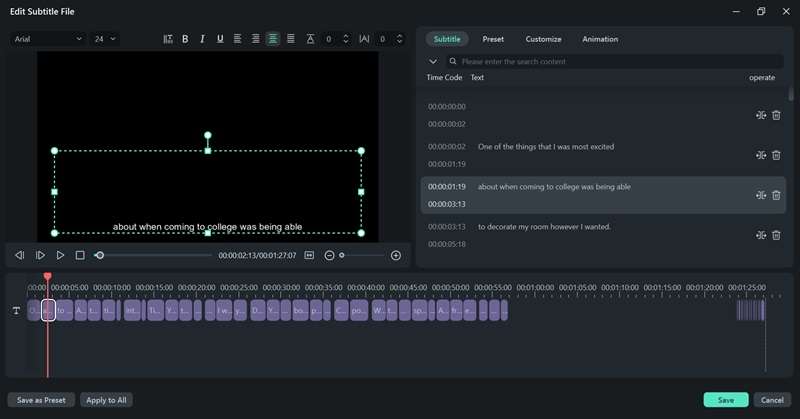
Pour modifier le texte, double-cliquez sur le fichier de transcription généré afin d'ouvrir l'éditeur. Vous pourrez relire le contenu et apporter les corrections nécessaires. Pour faciliter cette vérification, vous pouvez aussi activer la Correction intelligente du texte dans les paramètres de transcription vocale. Cette fonction signale automatiquement les passages susceptibles de contenir des erreurs et propose des corrections avant la validation des sous-titres.
Étape 6 : Enregistrer ou ajouter la transcription au projet
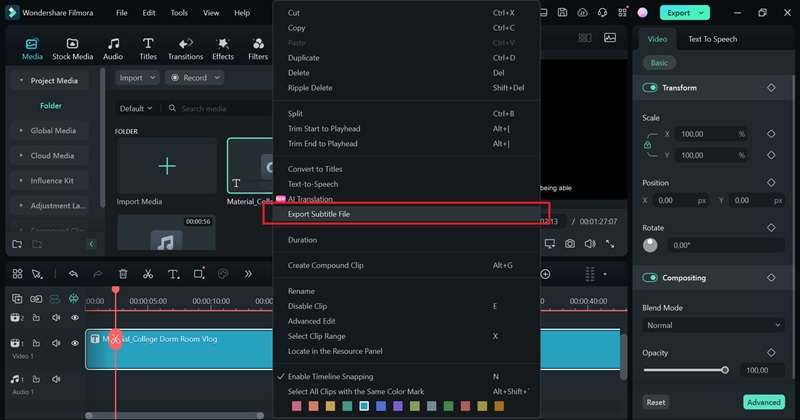
Après avoir effectué les modifications souhaitées, exportez la transcription au format SRT. Faites un clic droit sur la piste de sous-titres dans la timeline, puis sélectionnez « Exporter le fichier de sous-titres ».
Conclusion
Les API gratuites de transcription vocale permettent aux développeurs d'ajouter la reconnaissance de la parole à leurs applications tout en limitant les coûts. Nous avons présenté cinq solutions : Google Cloud Speech-to-Text, Microsoft Azure, Speechmatics, AssemblyAI et AWS Transcribe. Que vous souhaitiez réaliser un petit projet ou tester une fonctionnalité de transcription, leurs offres gratuites peuvent constituer un point de départ.
Si vous recherchez une solution plus simple, sans intégration technique, la fonction de transcription vocale intégrée à Filmora constitue une alternative pratique. Elle facilite la création rapide de transcriptions pour les vidéastes et les entreprises qui n'ont pas besoin de développer une intégration API.